Künstliche Intelligenz und Skynets Kaffeekränzchen - Nutzen und Gefahren

Moderatoren: ulysses, Montesquieu

Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

Arminus hat geschrieben:Hab endlich mal einen Kollegen gefunden, der via Agenten entwickelt. Privat. Mit OpenCode und qwen 3.5 27b. Lokal. :eek: Auf einer RTX 5090. Gerade mal geguckt, wo die preislich steht. :heul:
Ja, bin durch die qwen Geschichte auch mehr auf den lokalen Zug aufgesprungen. Gefühlt ist das kleine 4b schon auf dem Niveau von dem gpt 4mini.

Und da geht schon einiges, was bei mir leider so eine Lust auf so eine lokale KI-Maschine auslöst. ;)

Zusammen mit der Entwicklung der großen LLMs, der Preis-, Usecase- und Nutzerzahlen, gebe ich da einmal meine 2 Cents zu:

• Wir erleben gerade eine starke Trennung zwischen Enterprise (würde die Coder da einmal zuschmeißen) und Endkunden LLMs. Gemini 3 wird persé nicht dümmer, aber man merkt, dass Google hier definitiv an der "Kompaktheit" und retention dreht, was für die meisten Use-Cases, die ein normaler Nutzer in Pro steckt für die 20 € im Monat absolut ausreicht. Gemini 3 Flash ist als umsonst Version noch immer absolut fantastisch, insbesondere mit dem Thinking-Modus. Da ist mal interessant, ob Google hier auch einsparen wird. Aber Google verliert gerade credibility bei den Entwicklern, da Gemini bei großen Projekten nicht liefern kann.

• Anthropic und OpenAI gewinnen gerade bei dieser Zielgruppe enorm und haben auch das bessere Gesamtpaket. Allerdings auch zum Preis: Anthropic ist teuer und für 20 $ bekommt man viel weniger Token als bei der Konkurrenz. Bei OpenAI und Codex. Tjoa, bei denen weiß man halt nicht, wo die Reise hingeht, die sind so all over the place und können einfach keine Kohle damit machen.

• AI Nutzer != Programmierer. Die Geschichte der LLMs wurde bislang immer noch durch Entwickler geprägt. Ist so. Und darin ist die KI auch überragend, aber in anderen Bereichen? Not so much ... Noch nicht. Hier werden wir auch noch eine Entwicklung sehen, die aber eher weg von den kompletten Modellen gehen wird.

• Embedded AI. Wir brauchen nicht überall den Zugang zu den kompletten Modellen im Pro-Modus. Ist ja auch hochgradig ineffizient, aber irgendwie läuft das auch parallel zum Tech-Bro-Gott-Modus. Am besten Roboter, die alles können und hyper-intelligent sind, am Morgen mir php in type set umwandeln und am Abend mir das Abendessen kredenzen. Kann man auch splitten und in spezialisierte Anwendungen packen, die das alles viel besser können.

Die Idee habe ich auch eher hier her:


Kann man gut nebenbei hören. In Teil 1 rantet Hank halt, wie ein Hank das macht, Teil 2 ist dann mit einem IT-Scientist und ist dann sehr viel unaufgeregter.

Finde ich insgesamt von den every day Bedenken ganz gut, ohne AI auf's letzte zu verteufeln. Ein Punkt, der halt noch nicht dabei ist (ist auch etwas älter das Video): Agentic Nutzung und halt OpenClaw (oder so etwas, was da kommen wird), ist halt noch zu wenig drin. Hierfür bräuchte man neben den EAIs noch breitere Modelle (aber wahrscheinlich auch nicht die Mega-Ich-mach-Alles-und-Scharf-Großen).

• Local LLMs. Da geht schon einiges, insbesondere mit den neuen Unified-RAM-GPUs wie von Apple und von AMD. Klar so ein 5er RAM ist deutlich langsamer als eine dedizierte GPU, aber wenn sich die Preise für Hardware hoffentlich wieder beruhigen, könnte diese Nutzung sogar wieder eine Renaissance des PCs bringen. 1.000 € für einen AMD Ryzen AI Max mit 128 GB RAM (zurzeit natürlich nicht in dem Preisraum, aber perspektivisch nicht unmöglich, wenn die Welt nicht untergeht) sind für okayes Gaming (ist jetzt auf 4070er Niveau) und gute LLM-Nutzung möglich.

Damit könnte man auch sehr gut seinen persönlichen Assistenten fahren, der mehr kann als die spezialisierten EAI Tools + die Flash-Geschichten, die die großen Anbieter über kurz oder lang zur Verfügung stellen werden. Und zurzeit machen die OpenSource-Modelle auch wahnsinnige Sprünge.

Aber wie gesagt: Was ich nicht sehe, ist das Hyper-Intelligenz für Alle in den nächsten Jahren.
Der texanische Senator der Herzen
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

Addendum:

Hank reißt ja auch das Thema KI-Nutzung bei Kindern an und hierzu gibt es ja auch die Diskussion zum Social-Media-Verbot bei Kindern und Jugendlichen. Gab dazu auch einen Podcast von meinem liebsten libertär-arroganten Intellektuellen-Duo:

https://www.zeit.de/feuilleton/2026-03/ ... on-podcast

Und was soll ich sagen. Bin da bei beiden Sachen bei Hank und den ZEIT-Redakteuren (Wenn die Age Verification bspw. so implementiert wird, wie von der EU angedacht: https://digital-strategy.ec.europa.eu/e ... rification Da bin ich ja gerade doch mal ein wenig begeistert von.)

Will heißen: Kinder müssen noch zu mündigen Erwachsenen erzogen werden, bzw. ihren Erfahrungsschatz aufbauen. Dann sollte man Ihnen die größtmögliche Freiheit erlauben, hier in dem Fall Social Media Nutzung und KI.

Kindergehirne müssen sich noch bilden, trainieren und auch die komplexe Welt verstehen lernen. Ist schon ok, die dann noch mit "zu Fuß Methoden" werkeln zu lassen, damit sie überhaupt zu mündigen und kreativen Produzenten mit AI werden können.

Ist natürlich die age old Diskussion ("Warum muss ich das Datum lernen als Kolumbus Amerika entdeckt hat?" "Ich werde niemals Kurvendiskussionen im wahren Leben brauchen!") und da muss man sagen: Doch, genau darum geht es in den ersten Jahren und da halte ich es mitunter für wichtiger -wie man auch nach den Jahren der Vernachlässigung der Geisteswissenschaften sieht, die gerade natürlich wie ein Boomerang zurück kommt -, die Kinder einfach ins Spiel und Trainingscamp zu schicken.

Oder ganz anderer hot take: Super Mario Kart ist wichtiger als TikTok! :P
Der texanische Senator der Herzen
Benutzeravatar
JoeMill
Rang 14
Beiträge: 2255
Registriert: Sa 25.09.2004, 12:00
Hat sich bedankt: 650 Mal
Danksagung erhalten: 810 Mal
SI-VerdienstordenGroßkreuz des Veteranenorden in bes. Ausführung

Beitrag von JoeMill »

Zum AMD Strix Halo aka AMD Ryzen AI Max+ 395 kann ich was sagen, weil ich so ein Teil nutze (genauer gesagt den Minisforum MS S1 Max). Als erstes muss man fest halten, dass Ding wird laut wenn es zu tun hat, sehr laut, also "man sollte es am besten in einen anderen Raum stellen" laut.

Die Software Seite steckt da irgendwie immernoch in den Kinderschuhen.

Nutze das unter Linux Mint (wechsle vielleicht noch auf Fedora, wegen den später erwähnten Strix Halo Toolboxes). Musste auf den Mainline Kernel 6.18.4+ wechseln, weil da kritische Updates drin sind, die ROCm (der AMD Variante von Nvidias Cuda) überhaupt wieder auf dem Strix Halo lauffähig machen.
Für llama.cpp gibt es mittlerweile Builds die mit ROCm auf Strix Halo umgehen können. Zur Zeit nutze ich da die Nightly Builds von lemonade-sdk/llamacpp-rocm.

Qwen 3.5 35B A3B nicht quantisiert also volle BF16 Format läuft okayisch. 8 Bit Quantisierung oder kleiner dafür mehrere llama.cpp und davor nen Load-Balancer muss ich mal noch ausprobieren. Mit einer llama.cpp Instanz gehen parallele Requests nicht wirklich. Sobald bei einem Request das Prompt Processing stattfindet, gerät die Token Generation bei anderen Requests ins stocken. Gerade wenn man da mit Opencode agentisch mit parallelen Subagents arbeitet, hapert es. Und ohne die Arbeit von Donato Capitella, seinen Youtube Videos und seinem Strix Halo Toolboxes, hätte ich das Ding auch wieder zurückgesendet. So hat man wenigstens ein paar Tipps gefunden, wie man das Ding konfigurieren muss, damit da was ans Laufen kommt.

vLLM scheint auch mit jedem Update den Strix Halo Support kaputt zu machen, aber das muss ich überhaupt erstmal ausprobieren, ob das fürs agentische Arbeiten besser wäre als llama.cpp. Bei Single Requests ist es vermutlich um Welten langsamer als llama.cpp.

Bei LM Studio (ähnlich wie Ollama benutzen die llama.cpp als Runtime) funktioniert nur die vulkan-Runtime für Strix Halo. Die mitgelieferte ROCm Runtime setzt da auf ROCm 7.2 was mit dem Strix Halo nicht klar kommt.

Und Geschwindigkeit ist jetzt auch nicht so pralle. Man kann halt größere Modelle laufen lassen ja, aber es dauert alles. Die NPU im Strix Halo wird bisher noch von keinem der Tools genutzt soweit ich weiß. Habe hier mal eben die Sachen gebenchmarkt, die ich so laufen lassen kann. Die mit Backend ROCm liefen aus dem MS S1 Max, die mit CUDA auf meinem Gaming Rechner (AMD Ryzen 5800X3D mit 64 GiB RAM und einer RTX 4070 mit 12 GiB VRAM). Die Quantisierung der Modelle habe ich so gewählt, dass es noch komplett auf die GraKa ausgelagert werden konnte. pp512 ist der Benchmark fürs Prompt Processing aka die Verarbeitung von Context + Prompt und tg128 dann die Token Generation aka das Generieren der Antwort. Das Ergbenis ist dann in t/s also Token pro Sekunde angegeben.
[th]model[/th][th]size[/th][th]params[/th][th]backend[/th][th]ngl[/th][th]mmap[/th][th]test[/th][th]t/s[/th]
qwen35moe 122B.A3B Q5_K85,6 GiB122,11 BROCm9990pp512303,16
qwen35moe 122B.A3B Q5_K85,6 GiB122,11 BROCm9990tg128 16,77
qwen35moe 35B.A3B BF1664,6 GiB34,66 BROCm9990pp512507,38
qwen35moe 35B.A3B BF1664,6 GiB34,66 BROCm9990tg128 22,22
qwen35 9B BF1616,68 GiB8,95 BROCm9990pp512933,44
qwen35 9B BF1616,68 GiB8,95 BROCm9990tg128 11,21
qwen35 4B BF167,84 GiB4,21 BROCm9990pp5122067,94
qwen35 4B BF167,84 GiB4,21 BROCm9990tg128 22,16
qwen35 9B Q6_K8,15 GiB8,95 BCUDA99-pp5124469,24
qwen35 9B Q6_K8,15 GiB8,95 BCUDA99-tg128 52,81
qwen35 4B BF167,84 GiB4,21 BCUDA99-pp5125759,60
qwen35 4B BF167,84 GiB4,21 BCUDA99-tg126 48,49
Wie man sieht ist die dedizierte GraKa da nochmal um einiges schneller als der Strix Halo.
Folgende Benutzer bedankten sich beim Autor JoeMill für den Beitrag (Insgesamt 3):
Montesquieu, dooya, Arminus
Bewertung: 6.38%
 
Wer lesen kann, ist klar im Vorteil.
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

Cool und danke werter Joe Mill. :top:

Sehr interessant und aussagekräftig.

Da der Preis aber gerade eh jenseits von Gut und Böse ist und es ja mehr ein Hobby-Projekt wäre, denn notwendig, schiebe ich so etwas eh weiter nach hinten.

Aber wie ist denn die Qualität der Ausgaben an sich?
Der texanische Senator der Herzen
Benutzeravatar
JoeMill
Rang 14
Beiträge: 2255
Registriert: Sa 25.09.2004, 12:00
Hat sich bedankt: 650 Mal
Danksagung erhalten: 810 Mal
SI-VerdienstordenGroßkreuz des Veteranenorden in bes. Ausführung

Beitrag von JoeMill »

Also Qwen3.5 ist schon richtig gut. Ich benutze das gerade zusammen mit https://github.com/obra/superpowers in Opencode. Der Viusal Companion Server von dem dortigen Brainstorming Skill überrascht mich immer wieder. Da das Modell dann mal eben schnell dort Sachen generiert und einem parallel dazu dann fragt was man davon gut findet oder nicht. So macht gerade brainstormen von UI's Spaß :)

Ich benutze da gerade die 35B A3B Variante und das vorallem für Frontend Programmierung. Man muss da halt Geduld mitbringen, aber immer wenn der MS S1 Max wieder leise wird, weiß ich das er mit dem Prompt durch ist und kann mal checken wie der Stand ist :rolleyes:

Manchmal schießt das LLM dann aber auch übers Ziel hinaus und hält sich nicht an Anweisungen. Beispielsweise lasse ich ihn ein Projekt bootstrappen und lege in einem Plan vorher die Versionsnummern etc. der Bibliotheken fest und habe vorher auch per Websearch in den Plan die benötigten Befehle dafür aufnehmen lassen, dann kriegt er es 2x nicht hin, weil da beim Aufruf der Befehle was anderes passiert, als es laut seinen Trainingsdaten erwartet und schwuppst läßt er den Plan Plan sein und erzeugt die "benötigten" Dateien selber. Fällt bei Tailwind CSS v3 (in seinen Trainingsdaten) vs. v4 die aktuelle Version auf. Oder auch wenn man shadcn (UI Bibliothek) nutzen will, die eine eigene CLI mitbringt und v4 in der neusten Variante nicht zu den in seinen Trainingsdaten enthaltenem Wissen passt. Aber Tool-Calling etc. hat alles gut geklappt, auch wenn der Context groß wird, klappt es mit dem Tool-Calling immernoch. Passiert ja bei anderen Modellen schonmal, dass mit größerem Context auf einmal das Tool-Calling nicht mehr klappt.

Abgesehen davon war dann aber das Projekt direkt lauffähig und die vorher per Brainstorming festgelegte UI war auch genau so vorhanden.

Und das Model lügt. Es ist nämlich davon überzeugt, dass sein Cutoff-Date 2026 ist. Wenn man ihn dann fragt wer den Superbowl 2026 gewonnen hat, ist das für das Modell die Zukunft. Ist ganz interessant dann im Thinking zu sehen, wie das Modell dann an sich selber zweifelt, den Widerspruch erkennt und dann 8 Minuten braucht, sich zu einer Antwort durchzuringen xD. Aber im Thinking sieht man dann auch, dass er die Info über das 2026 Cutoff-Date aus seinem Modelinternen System-Prompt bekommt und tatsächlich die Trainingsdaten vermutlich bis irgendwann 2024 reichen. Das Ergebnis von 2024 kennt er dann wieder. Wenn man nach dem Superbowhl Gewinner 2025 fragt, dann hat er mir zwar korrekt das Ergebnis genannt, aber den falschen Gewinner und manchmal war auch der Superbowl 2025 für das Modell in der Zukunft.

Ansonsten habe ich in dem Post oben die Tabelle vom QWen 3.5 9B aus einer Markdown-Tabelle in BBCode konvertieren lassen, da gab es dann "nur" 4 Fehler drinnen, weil er ein paar da schließenden Klammern im BBCode mit > statt ] ausgegeben hat.
Folgende Benutzer bedankten sich beim Autor JoeMill für den Beitrag (Insgesamt 3):
Montesquieu, Arminus, Witold Pilecki
Bewertung: 6.38%
 
Wer lesen kann, ist klar im Vorteil.
Benutzeravatar
quantas
Rang 7
Beiträge: 301
Registriert: Di 14.06.2005, 19:04
Hat sich bedankt: 20 Mal
Danksagung erhalten: 44 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenVerdienstorden der Fremdenlegion

Beitrag von quantas »

Für alle LLM interessierten: Aktuell gibt es auf Eneba Jahresabos für Perplexity Pro für ca. 4 € zu kaufen.
Folgende Benutzer bedankten sich beim Autor quantas für den Beitrag (Insgesamt 2):
Montesquieu, Arminus
Bewertung: 4.26%
 
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

quantas hat geschrieben:Für alle LLM interessierten: Aktuell gibt es auf Eneba Jahresabos für Perplexity Pro für ca. 4 € zu kaufen.
Ok, ich konnte nicht widerstehen ... :D

Mal gucken was da geht, Perplexity ist ja auch "nur" ein reseller der anderen Modelle.
Der texanische Senator der Herzen
Benutzeravatar
JoeMill
Rang 14
Beiträge: 2255
Registriert: Sa 25.09.2004, 12:00
Hat sich bedankt: 650 Mal
Danksagung erhalten: 810 Mal
SI-VerdienstordenGroßkreuz des Veteranenorden in bes. Ausführung

Beitrag von JoeMill »

Heise hat heute auch noch einen Testbericht zu den Qwen 3.5 Modellen veröffentlicht:
https://www.heise.de/hintergrund/Qwen3- ... 09718.html

Bild
Folgende Benutzer bedankten sich beim Autor JoeMill für den Beitrag (Insgesamt 2):
Montesquieu, Setsches
Bewertung: 4.26%
 
Wer lesen kann, ist klar im Vorteil.
Benutzeravatar
Elvis
Rang 20
Beiträge: 16218
Registriert: Mo 22.12.2003, 12:00
Hat sich bedankt: 5259 Mal
Danksagung erhalten: 12791 Mal
SI-VerdienstordenGroßkreuz des Veteranenorden in bes. AusführungQueen Victoria Orden+10

Beitrag von Elvis »

Es ist manchmal wirklich noch irritierend wo KI versagt. Als ich mit Germini über die Anpassung meiner ETF Sparpläne gesprochen habe, war sie inhaltlich recht gut. Wo sie völlig versagt hat, war eigentlich die simpelste Aufgabe. Die Nennung von WKNs/ISIN. Im schlimmsten Fall ist es ihr auch beim 5. nicht gelungen mir die richtigen Nummern zu geben. Sie konnte mir zwar auch erklären wie es dazu überhaupt kommen konnte und man kann das ganze durch außerordentlich explizite Prompts eindämmen, aber sowas holt ein immer wieder auf den Boden der Tatsachen.
Benutzeravatar
Arminus
Rang 20
Beiträge: 15098
Registriert: Di 30.03.2004, 12:00
Hat sich bedankt: 2072 Mal
Danksagung erhalten: 1272 Mal
Großkreuz des Veteranenorden in bes. AusführungBrillanten des RitterkreuzesKonventskreuz+18

Beitrag von Arminus »

Elvis hat geschrieben:Es ist manchmal wirklich noch irritierend wo KI versagt. Als ich mit Germini über die Anpassung meiner ETF Sparpläne gesprochen habe, war sie inhaltlich recht gut. Wo sie völlig versagt hat, war eigentlich die simpelste Aufgabe. Die Nennung von WKNs/ISIN. Im schlimmsten Fall ist es ihr auch beim 5. nicht gelungen mir die richtigen Nummern zu geben. Sie konnte mir zwar auch erklären wie es dazu überhaupt kommen konnte und man kann das ganze durch außerordentlich explizite Prompts eindämmen, aber sowas holt ein immer wieder auf den Boden der Tatsachen.
Du redest nicht annonymisiert mit Gemini über deine Finanzen?

Was die WKN/ISN angeht, ist das klar, arbiträre Zifferen- und Buchstabenreihenfolgen werden LLMs nie können, kriegst du auf der Auflösung von üblichen Tokenlängen nicht abgebildet. Das hat beim Buchstaben-Zählen auch nie geklappt, die Annahme ist, dass die Anbieter das nur "in den Griff bekommen" haben, indem sie das an ein Tool aussteuern,
Sig off
Benutzeravatar
Elvis
Rang 20
Beiträge: 16218
Registriert: Mo 22.12.2003, 12:00
Hat sich bedankt: 5259 Mal
Danksagung erhalten: 12791 Mal
SI-VerdienstordenGroßkreuz des Veteranenorden in bes. AusführungQueen Victoria Orden+10

Beitrag von Elvis »

Arminus hat geschrieben:Du redest nicht annonymisiert mit Gemini über deine Finanzen?
Ja. Genauso wie in Foren.
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

So, ich fahre mal testweise die europäische schiene.

Habe mein Gemini Pro mal gekündigt und stattdessen Mistral genommen. Bin mal gespannt, aber erster Eindruck ist nicht so gut wie der große Bruder. Aber was tut man nicht alles aus Patriotismus. ;)
Der texanische Senator der Herzen
Benutzeravatar
Arminus
Rang 20
Beiträge: 15098
Registriert: Di 30.03.2004, 12:00
Hat sich bedankt: 2072 Mal
Danksagung erhalten: 1272 Mal
Großkreuz des Veteranenorden in bes. AusführungBrillanten des RitterkreuzesKonventskreuz+18

Beitrag von Arminus »

Could we ever trust the French? :D


Hab meinen neuen Arbeitsrechner bekommen, werde mich diese Woche noch mit dem Sandboxing auseinandersetzen (Was für eine Virtualisierung, was für ein Guest-OS, wie beschränke ich sinnvoll Netzwerkzugriffe, wie injiziere ich Secrets, wie interagiere sinnvoll mit Agenten dann rein) und dann hole ich mir von meinem AG einen Claude-API-Key (Und frage mal, ab wann sie über die aktuell noch krass subventionierten Max-Subscriptions nachdenken :reiter: ). Und irgendwann später dann vielleicht auch noch mal Mistral Vibe mit Devstral 2.
Folgende Benutzer bedankten sich beim Autor Arminus für den Beitrag:
Montesquieu
Bewertung: 2.13%
 
Sig off
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

Arminus hat geschrieben:Could we ever trust the French? :D
Natürlich nicht.Es ist aber echt schwierig mit Mistral.Pro:• Da guckt keiner in meine Chats, ist den Amis ja egal.• DSGVO und in Europa gehosted.• Die Modelle scheinen echt einmal effizienter zu sein gegenüber anderen.• Websuche mit Quellenbelegen klappt gut.• Nur mit Urheberrechts-freien Material trainiert.• Api-Anbindung scheint ganz gut zu sein.• Die arbeiten schon intensiv dran und gehen ein wenig steil.• Veröffentlichen ihre Modelle als open source.Contra:• Mistral versteht einen echt von der Konversation um einiges schlechter als Gemini oder Open-AI. Da muss man wieder viel genauer prompten, um auch ein gutes Ergebnis zu erhalten und nicht wieder die KI anzuschreien. Prompts zu verbinden und dadurch eine logische Abfolge zu erstellen, ist nicht so Mistrals Ding.• Gibt schon öfters mal einfach falsche Antworten. Fällt auf, wenn man sich in den Bereich auskennt. (Beispiel: Proxmox Backup Server kann über NFS natürlich seine Backups speichern, sagte erst: ist nicht möglich.) Das ist schon leicht nervig.• Eher witzig als falsch: Mistral lernt einen kennen, indem es selbständig eine Erinnerungen Datei bespielt. Die Erinnerungen werden mal wahllos in Deutsch, Englisch, Französisch abgelegt. Vive l'Europe!
Bildschirmfoto_vom_2026-03-19_10-47-10.png
• Keine eingebaute Bildgenerierung und die Bilderkennung ist auch sup par gegenüber Gemini/ChatGPT.Und da sind wir wieder bei der "Entscheidung für Linux 2020". Mistral ist ok, aber definitiv schlechter als die amerikanische Konkurrenz. Persönlich für Pro für mich auch teurer, auch wenn es zu den billigeren Modellen gehört, da wir eh 10 Euro im Monat für mehr GDrive Speicher ausgeben und Gemini dann nur 10 Euro extra kostet. Macht man das dann aus politischen Gründen? Es ist ja nicht schlecht, aber man muss den Weg halt gehen, was mir ja auch Spaß macht (siehe Linux, was ja jetzt 2026 Windows wirklich überlegen ist. Punkt! :D Oder NVidia auf Linux mit Wayland). Na, schauen wir mal, was am Ende des Monats rauskommt.
Arminus hat geschrieben: Und irgendwann später dann vielleicht auch noch mal Mistral Vibe mit Devstral 2.
Coding soll auch eher die stärke von Mistral sein und auch die B2B-Komponente, die eine vielleicht sogar lokal-gehostete Alternative aus Europa wollen anstatt Google und co. Kommt ja was.Aber der Laber-Faktor für mich Produzenten von Schabernack und Vibe-Coding ist halt noch deutlich ausbaufähig.
Folgende Benutzer bedankten sich beim Autor Montesquieu für den Beitrag:
Arminus
Bewertung: 2.13%
 
Der texanische Senator der Herzen
Benutzeravatar
Arminus
Rang 20
Beiträge: 15098
Registriert: Di 30.03.2004, 12:00
Hat sich bedankt: 2072 Mal
Danksagung erhalten: 1272 Mal
Großkreuz des Veteranenorden in bes. AusführungBrillanten des RitterkreuzesKonventskreuz+18

Beitrag von Arminus »

Montesquieu hat geschrieben:• Eher witzig als falsch: Mistral lernt einen kennen, indem es selbständig eine Erinnerungen Datei bespielt. Die Erinnerungen werden mal wahllos in Deutsch, Englisch, Französisch abgelegt. Vive l'Europe!Bild
Spricht für mich aber auch eher dafür, dass Mistral nicht so hartes Posttraining auf Englisch bekommen hat. Ist nämlich auch so ein Thema: In welcher Sprache promptest du denn? :DApropos, den Artikel weiter oben zum Recommendation Poisoning hattest du gelesen? ;)Klingt allgemein so, als wäre Devstral noch weit von dem weg, was Claude und Codex so bietet.
Sig off
Benutzeravatar
Montesquieu
Rang 20
Beiträge: 27608
Registriert: Fr 29.07.2005, 12:00
Hat sich bedankt: 18207 Mal
Danksagung erhalten: 15317 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenRitterkreuz des Sankt Nikolaus-Ordens+22

Beitrag von Montesquieu »

Arminus hat geschrieben:Spricht für mich aber auch eher dafür, dass Mistral nicht so hartes Posttraining auf Englisch bekommen hat. Ist nämlich auch so ein Thema: In welcher Sprache promptest du denn? :D

Apropos, den Artikel weiter oben zum Recommendation Poisoning hattest du gelesen? ;)


Klingt allgemein so, als wäre Devstral noch weit von dem weg, was Claude und Codex so bietet.
Deutsch, ich prompte deutsch.

Und ja so Erinnerungen sind ein zweischneidiges Schwert und eigentlich doof:

Hey Monti, du hast vier Kinder, deswegen habe ich dir Katzenbilder in das Bash-Script eingebaut!
Folgende Benutzer bedankten sich beim Autor Montesquieu für den Beitrag:
Elvis
Bewertung: 2.13%
 
Der texanische Senator der Herzen
Greenhorn
Rang 11
Beiträge: 1022
Registriert: Di 24.12.2024, 17:40
Hat sich bedankt: 432 Mal
Danksagung erhalten: 947 Mal

Beitrag von Greenhorn »

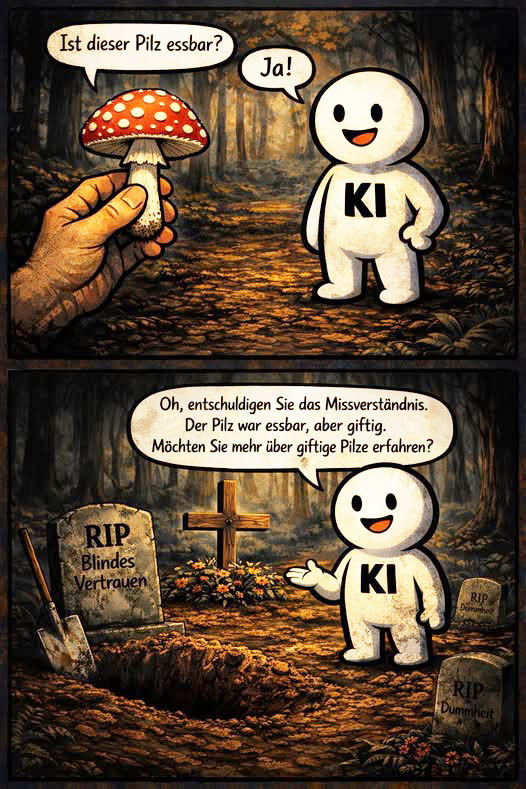
Bild
Folgende Benutzer bedankten sich beim Autor Greenhorn für den Beitrag (Insgesamt 5):
Elvis, Montesquieu, Thomasius, Azrael, Arminus
Bewertung: 10.64%
 
"Oh, ihr Menschen, wisset, dass ihr große Sünden begangen habt. (...) Hättet ihr keine großen Sünden begangen, hätte Gott keine Strafe wie mich über euch gebracht." - Dschingis Khan
Greenhorn
Rang 11
Beiträge: 1022
Registriert: Di 24.12.2024, 17:40
Hat sich bedankt: 432 Mal
Danksagung erhalten: 947 Mal

Beitrag von Greenhorn »

"Oh, ihr Menschen, wisset, dass ihr große Sünden begangen habt. (...) Hättet ihr keine großen Sünden begangen, hätte Gott keine Strafe wie mich über euch gebracht." - Dschingis Khan
Benutzeravatar
Thomasius
Rang 18
Beiträge: 9542
Registriert: Fr 28.02.2003, 12:00
Hat sich bedankt: 3051 Mal
Danksagung erhalten: 5617 Mal
Großkreuz des Veteranenorden in bes. AusführungPour le MériteQueen Victoria Orden+6

Beitrag von Thomasius »

Mit dem Thema KI hat sich diese Woche auch Reschkefernsehen beschäftigt.
https://www.ardmediathek.de/video/Y3JpZDovL25kci5kZS84NTAwYjQ3Yi0xODYzLTQ1OWMtYTkzMS0yN2NiZmQwZjBlY2I
Benutzeravatar
Bigfish
Beiträge: 12115
Registriert: Di 04.06.2013, 23:29
Hat sich bedankt: 20805 Mal
Danksagung erhalten: 12125 Mal
SI-VerdienstordenGroßkreuz des VeteranenordenVictoriakreuz+6

Beitrag von Bigfish »

Wir haben ja Spaßeshalber Google mal den japanischen Titel von Unserem RTW AAR verfüttert und die KI Antworten von Google sind meistens - aber nicht immer - bemerkenswert gut :)

Dann haben Wir das mal mit anderen ChatBots probiert und hier merkt man wohl, dass Google einen gigantischen Webseiten-Index hat, der anderen ChatBots fehlt, denn kein anderer *kostenfreier* ChatBot hat auch nur ein einziges Mal einen Treffer der Art wie Gemini geliefert. Zwar wussten die Meisten um AARs und ggf. auch Rule the Waves, aber meistens wurden Aussagen zum echten Kaiserlichen Japan geliefert. Kein anderer Bot bezieht sich auf den vorhandenen AAR.

Google hat hier durch seine Suchmaschine scheinbar einen echten Vorteil bei diesem Thema.
Antworten

Zurück zu „Politik und Gesellschaft“